Verda GPU S
ab 790 €
pro Monat · netto
Inference im Produktivbetrieb: Chatbots, RAG, Dokumenten-KI, Bildanalyse.
- NVIDIA RTX 4000 SFF Ada, 20 GB
- Dedizierter Server, keine geteilte GPU
- Root-Zugang
- Managed Betrieb inklusive
Dedizierte GPU-Leistung aus Deutschland.
Eigene NVIDIA-GPUs statt geteilter Cloud-Instanzen — mit Root-Zugang, festen Monatspreisen und einem Team, das Einrichtung, Überwachung und Updates übernimmt.
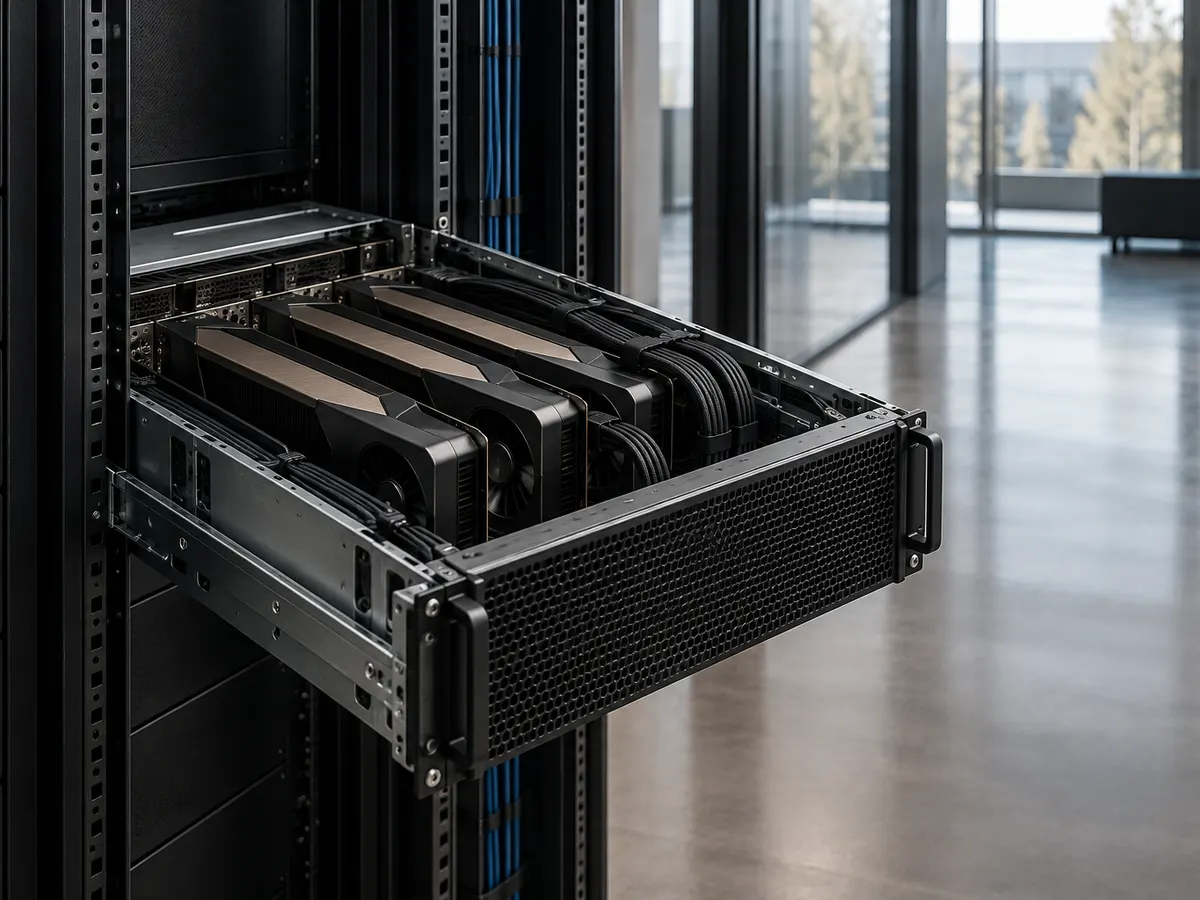
Die Konfiguration aus CPU, Arbeitsspeicher und NVMe-Storage stimmen wir auf Ihren Workload ab. Was im Monatspreis steckt und wovon die Kosten abhängen, zeigt der Ratgeber KI-Server Preise und Kosten; alle Pakete stehen in der Preisübersicht.
Inference im Produktivbetrieb: Chatbots, RAG, Dokumenten-KI, Bildanalyse.
Große Modelle, Fine-Tuning und rechenintensive Workloads.
Mehrere GPU-Server mit dediziertem Netzwerk für hohe Last.
Nur für Unternehmer (§ 14 BGB) · Alle Preise netto zzgl. USt. · 12 Monate Laufzeit · Einrichtung nach Angebot
Sie bekommen eine betriebsbereite Umgebung und einen festen Ansprechpartner statt eines Ticketsystems.
Lokale Sprachmodelle für Wissenssuche und Assistenten.
Bildanalyse, Objekterkennung, Qualitätsprüfung.
Eigene Modelle auf Unternehmensdaten anpassen.
OCR, Textextraktion und Klassifizierung.
Analyse, Konzeption und Projektumsetzung übernimmt unsere Schwestermarke VerdaGen.ai — die Infrastruktur dafür betreiben wir hier bei Verdacloud.
Nennen Sie uns Workload, Datenmenge und Nutzerzahl — Sie erhalten ein konkretes Angebot mit Festpreis.